はじめに
こんにちは。Cloud1課のチェです。
AWS Summit Japan 2026では、AI関連サービスのさらなる拡充と進化が大きな見所となっていました。 最近話題の生成AIですが、「社内データと連携させたい」「セキュアな環境でLLMを使いたい」という時におすすめなのがAmazon Bedrockです。
Amazon Bedrockを実際に触ってみたら驚くほど簡単にAPI経由でテキスト生成ができたので、導入手順から簡単なプログラムでの実行までをまとめてみました!
Amazon Bedrockとは?
Amazon Bedrockは、Amazonや主要なAI関連企業(Anthropic、Cohere、Metaなど)が提供する高性能な基盤モデルをAPI経由で利用できるフルマネージド型サービスです。
なぜBedrockなのか?
モデルの選択肢が豊富: 話題のClaudeのモデルや、メタの「Llama」、Amazonの「Nova」などが1つのインターフェースで使えます。
サーバーレスで運用が容易: インフラの管理が一切不要で、使った分だけの従量課金です。
社内データとの連携(RAG構築)が容易: 「Knowledge Bases for Amazon Bedrock」という機能を使えば、S3などにアップロードした社内ドキュメントを指定するだけで、自動でベクター化・検索インデックス構築を行い、社内情報に基づく正確な回答を生成できます。
とりあえず動かしてみる
AWSマネジメントコンソールにサインインし、「Amazon Bedrock」の画面を開きます。(東京リージョンでも対応していますが、最新機能が揃う us-east-1 (バージニア北部) または us-west-2 (オレゴン) がおすすめです)。
Bedrockのモデルを試す手順は非常にシンプルで、「モデルカタログ」から使いたいモデルを選ぶだけですぐに利用できます。
今回使うモデルとしてAmazonから開発された「Nova」を選択して進めたいと思います。
左メニューから 「モデルカタログ(Model catalog)」 を選択します。
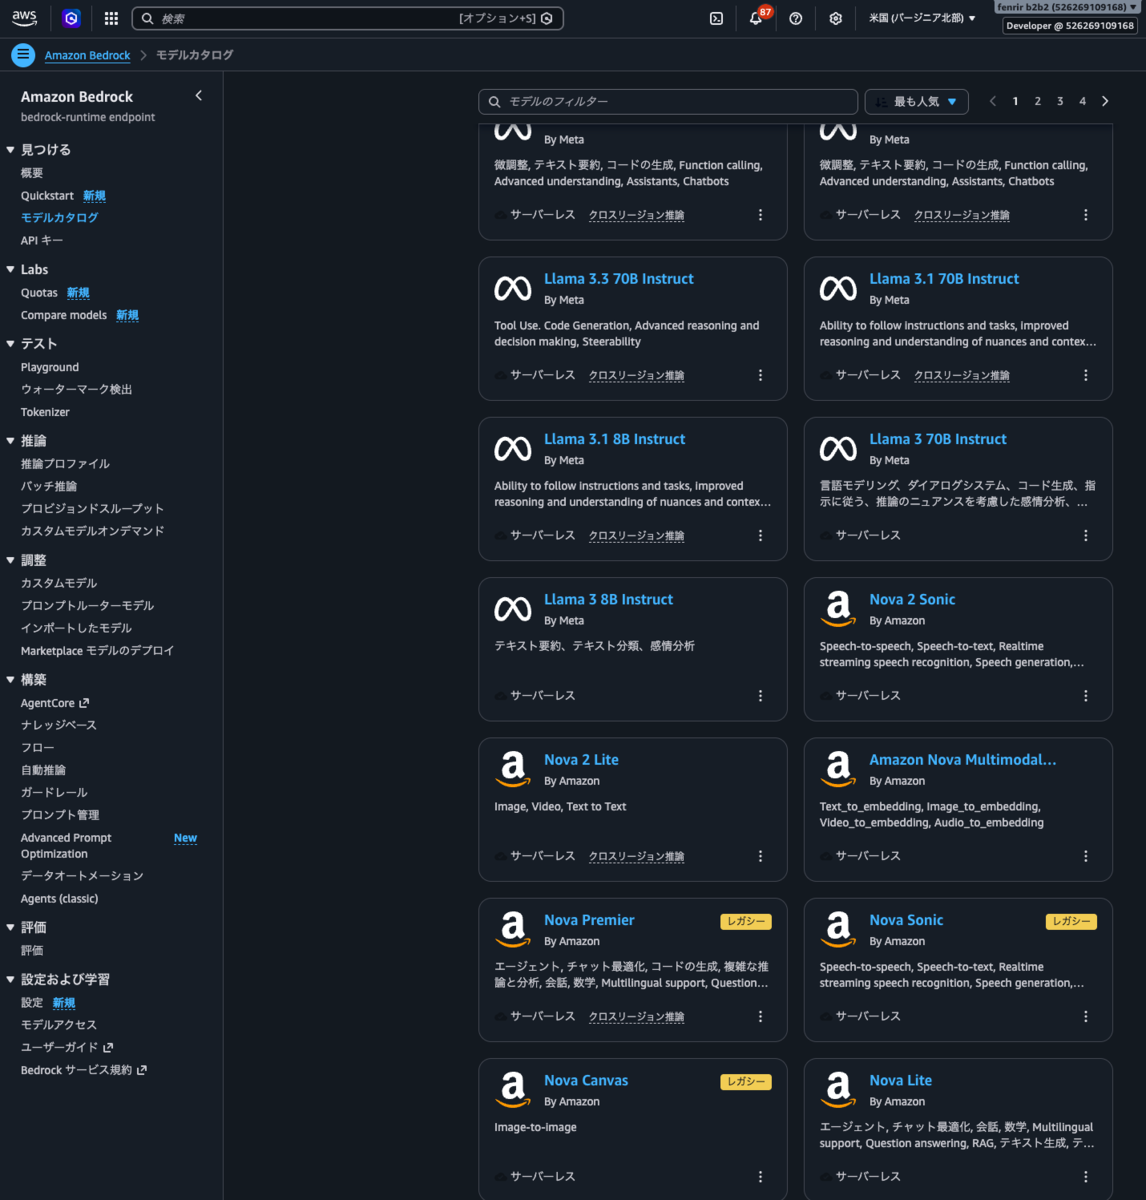
プロバイダー一覧から「Amazon」を選択するか、検索窓に「Nova」と入力して、今回使いたい 「Nova Lite」 や 「Nova Pro」 のカードをクリックします。
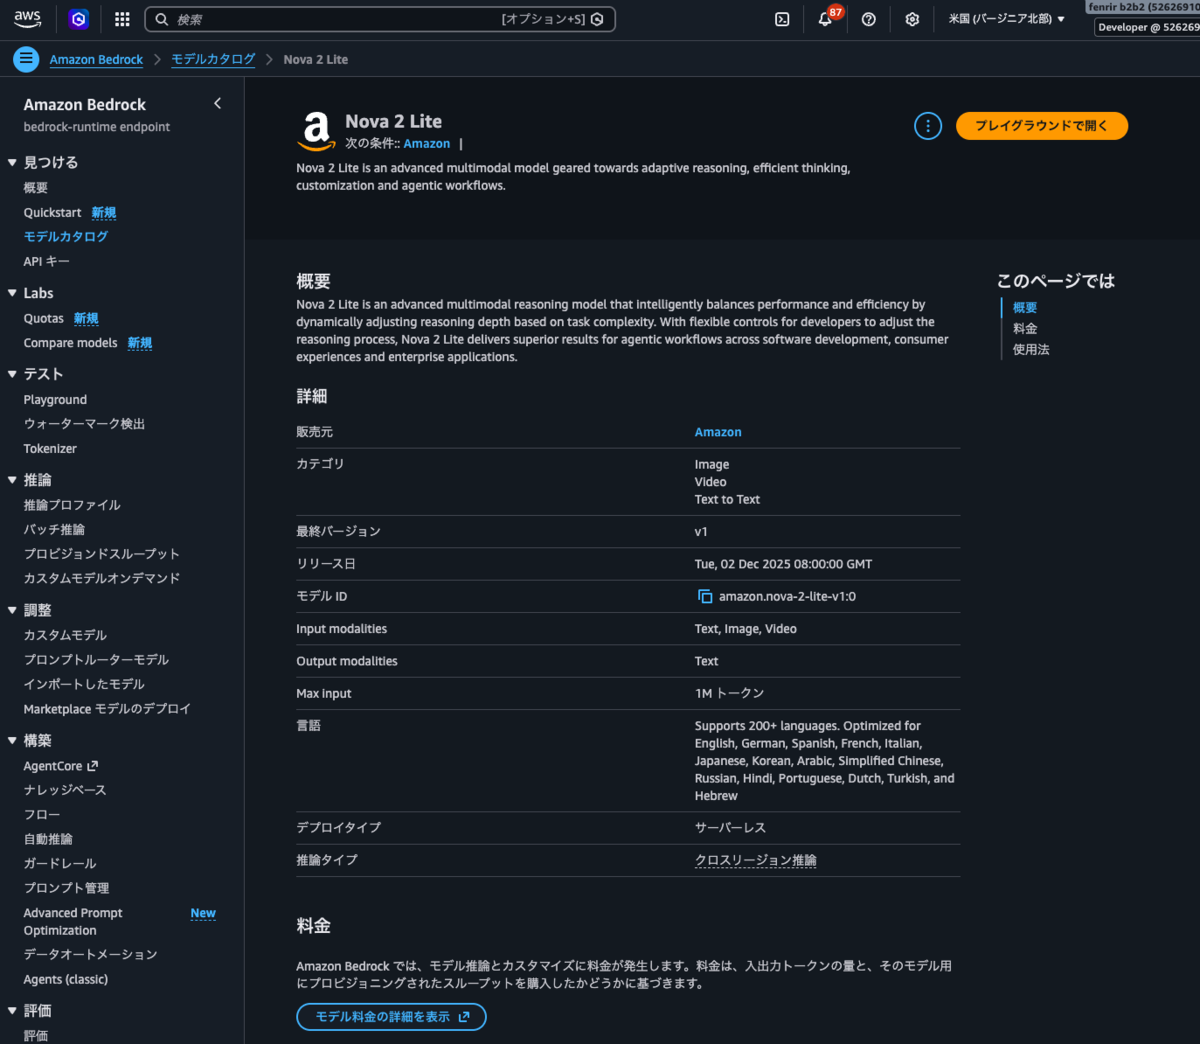
画面右上にある 「プレイグラウンドで開く(Open in playground)」 ボタンを押せば、すぐにテスト画面へと進めます!
触ってみた①:Playgroundで試す
コードを書く前に、まずはブラウザ上で動かしてみましょう。
左メニューの 「Playgrounds」 > 「Text(またはChat)」 を選択します。 画面上部で、先ほど確認したモデル(今回はAmazon / Nova Lite)を選択します。
右側のプロンプト入力欄に、適当な質問を投げてみます。
Amazon Bedrockのメリットを3つ、分かりやすく説明してください。
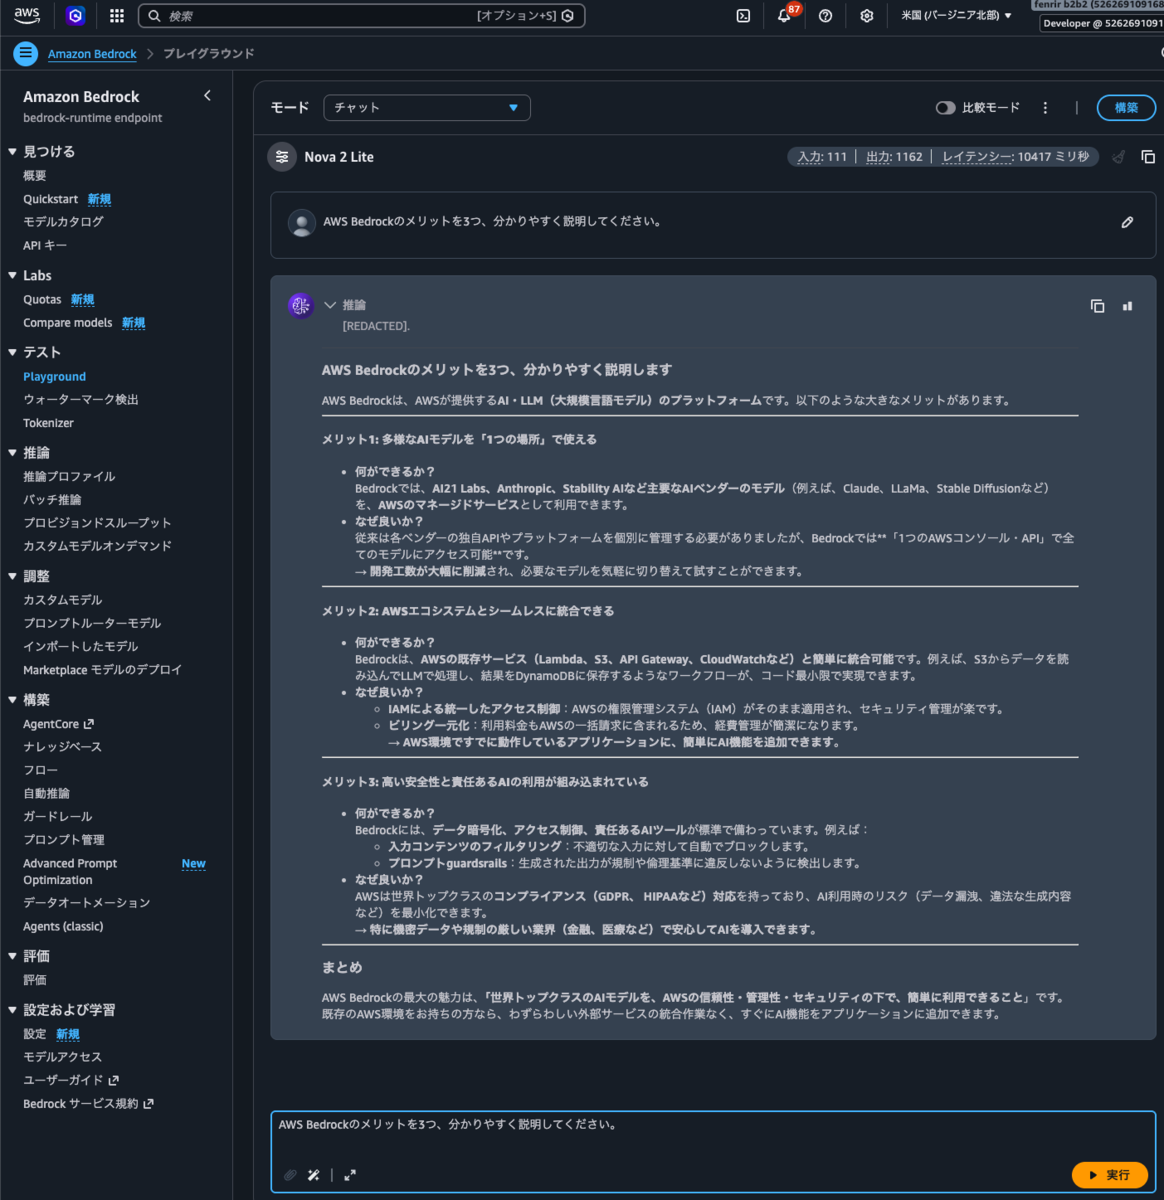
「実行(Run)」 を押すと、爆速で回答が返ってきました!
パラメータをGUI上で調整しながら挙動を確認できるので、簡易なプロンプトの調整にも使えます。
触ってみた②:Python (Boto3) からAPIを叩いてみる
ここからが本番です。ローカルのPython環境からBedrockのAPIを呼び出してみます。
必要なライブラリのインストール AWS SDKである boto3 をインストールします。
pip install boto3
(※ローカル環境にAWSの認証情報 ~/.aws/credentials が設定されている前提で進めます)
サンプルコード
今回は、コストと速度のバランスが良いマルチモーダルモデル Amazon Nova Lite を使ってテキストを生成するスクリプトを書きました。
import boto3
import json

# Bedrockのクライアントを作成 (バージニア北部リージョンを指定)
bedrock_runtime = boto3.client(
    service_name='bedrock-runtime',
    region_name='us-east-1'
)

# 使用するモデルのIDを指定 (Amazon Nova Lite)
model_id = 'amazon.nova-lite-v1:0'

# プロンプトの設定
prompt = "Amazon Bedrockのメリットを3つ、分かりやすく説明してください。"

# 起動パラメータの作成 (Amazon Nova用のフォーマット)
body = json.dumps({
    "inferenceConfig": {
        "max_new_tokens": 1000,
        "temperature": 0.7
    },
    "messages": [
        {
            "role": "user",
            "content": [
                {
                    "text": prompt
                }
            ]
        }
    ]
})

try:
    # APIの呼び出し
    response = bedrock_runtime.invoke_model(
        body=body,
        modelId=model_id,
        accept='application/json',
        contentType='application/json'
    )

    # レスポンスの解析
    response_body = json.loads(response.get('body').read())
    output_text = response_body['output']['message']['content'][0]['text']

    print("--- AIからの回答 ---")
    print(output_text)

except Exception as e:
    print(f"エラーが発生しました: {e}")
実行結果
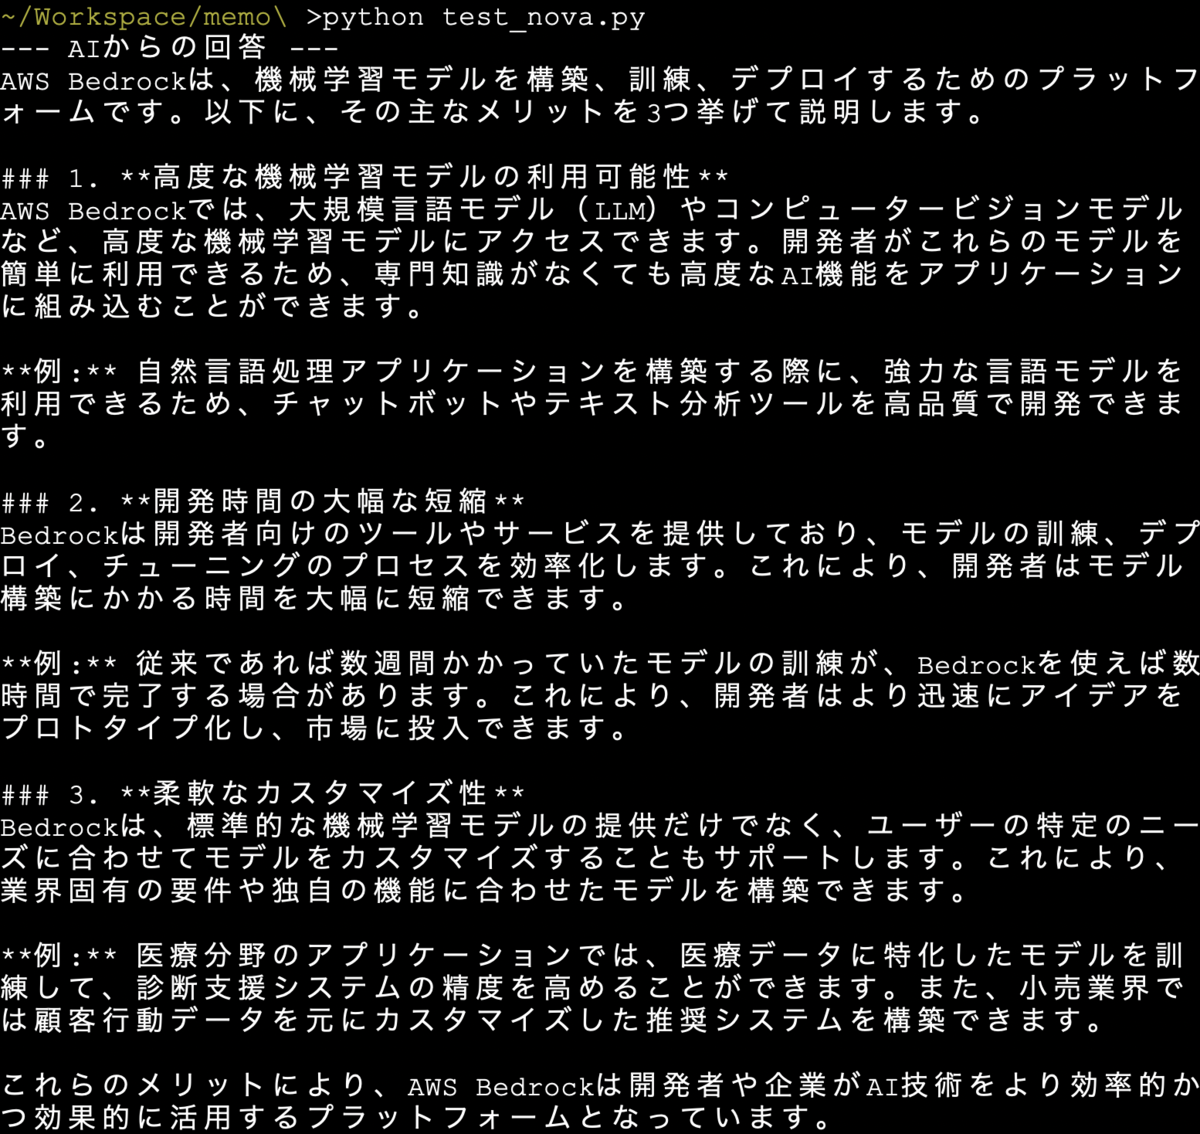
実行すると、コンソールにAmazon Bedrockのメリットを三つ紹介してくれる見事な答えが出力されました!
invoke_model というシンプルな関数を呼ぶだけで、他のLLM APIと同じような感覚で実装できるのが楽な感じでした。
触ってみて感じたこと
実際にAmazon Bedrockを使ってみて、以下の点が特に素晴らしいと感じました。
APIの統一感: モデルが変わっても invoke_model を叩く構造は同じなので、モデルの切り替えや比較のしやすさ。
思ったより簡単: サービス全体がシンプルに整理されており、テンプレートコードのみでAIモデルのAPI呼出を行える手軽さ・実装のしやすさ。
セキュリティの安心感: AWSのVPC内にデータを閉じた状態でLLMを活用できるため、情報漏洩の心配がなく利用のしやすさ。
今後は、社内ドキュメントを読み込ませた RAG(Knowledge Bases for Amazon Bedrock) の構築や、複数の処理を自動化する Agents for Amazon Bedrock にも挑戦してみたいと思います!
それでは、楽しいAI開発ライフを!
